공공 챗봇 RAG 구성과 크롤링 허용 범위
API 없이 답하는 공공 챗봇 RAG의 모델 구성과 벡터 DB 팁, 크롤링 허용 범위를 둘러싼 의견을 정리한 공공AX 네트워크 대화
오전 10시 52분, 기관 홈페이지에 AI API를 붙이겠다는 계획을 밝힌 참가자가 질문을 던졌다. 외부 AI API를 쓰면 이용자 질의가 모두 외부로 넘어간다는 우려가 나온 뒤였다.
그럼 ai api 안 쓰고 자연어처럼 답변할 수 있는 방법 있을까요??
로컬에서 하면 된다는 답과 RAG 오픈소스가 있을 것이라는 말이 먼저 나왔다. 아래 구성은 모두 참가자들이 경험에 비춰 낸 의견이며, 정답으로 합의된 것은 아니다.
모델은 몇 개가 필요한가
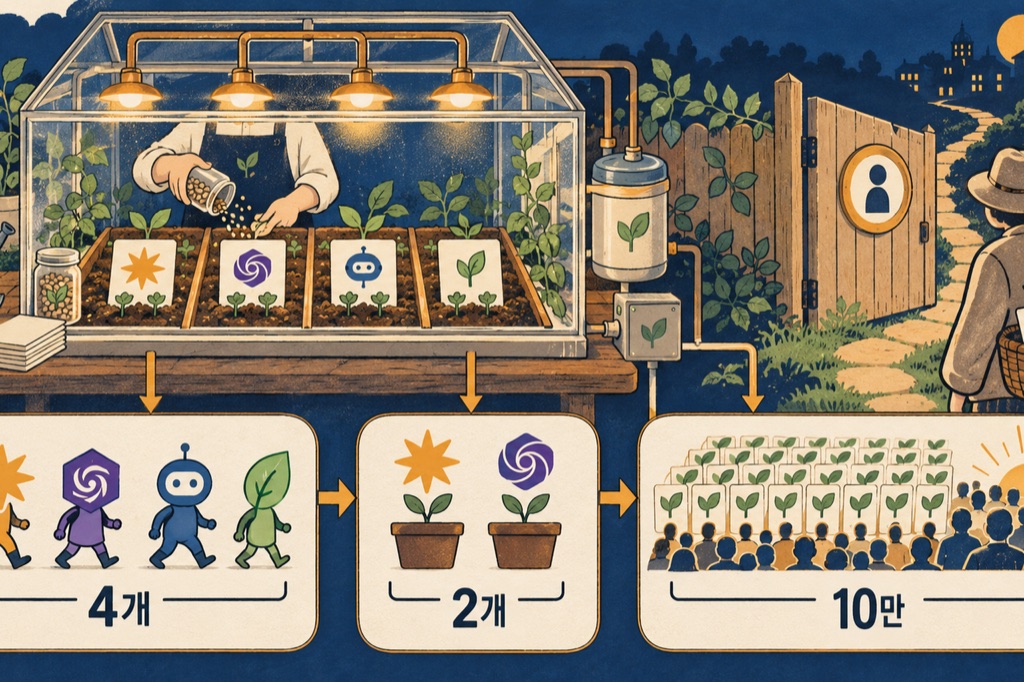
가장 먼저 갈린 것은 모델 수였다. 한 참가자가 RAG라면 모델이 4개는 필요하겠다고 하자, 질의와 답변이니 2개 아니냐는 반문이 나왔다. 기초 형태는 LLM과 임베딩(글을 검색용 숫자값으로 바꾸는 모델)이고, 4개로 늘리면 생성 모델과 임베딩 모델, 리랭킹(검색 결과의 순서를 다시 매기는 단계), 판단 단계가 된다는 설명이 이어졌다.
소규모 부서라면 2개로 먼저 시작해도 된다는 조언이 붙었다.
보통 2개로 만족할만한 결과가 나오면 2개로 하죠
벡터 DB와 임베딩 모델
한 참가자가 개인 프로젝트 단위라 독립 DB를 쓸 것이라고 하자, 그런 경우 권한 경계는 굳이 두지 않아도 된다는 답이 나왔다. 다른 참가자는 조직 대상이 아니라면 세 가지면 충분하다고 정리했다. pgvector는 벡터를 저장하고 검색하는 데이터베이스 확장을 가리킨다.
조직대상의 RAG가 아니라면 llm / embed / pgvector 세개로 충분합니다.
임베딩 모델로는 qwen 0.6이나 gemma 2 embedding 0.7B가 괜찮다는 추천이 나왔다. 개인 프로젝트를 말한 참가자는 sqlite만 썼는데 포스트그리가 더 좋아 보인다고 했고, 배포용 프로그램이라 300메가도 부담이라는 용량 고민도 털어놨다. 이에 압축해서 쓰면 10만 벡터도 1기가가 안 된다는 답이 돌아왔다. 한국어는 토크나이저 문제가 있으니 클로드에게 찾게 하면 된다는 팁도 붙었다.
크롤링은 어디까지 허용되나
질문한 참가자가 자료 수집 계획을 밝히자 경고가 이어졌다. 언론사를 크롤링하면 고소·고발을 당할 수 있다는 의견이 있었고, 크롤링은 안 하는 편이 낫다는 말도 나왔다. 반대로 이런 의견도 있었다.
크롤링자체는 불법이 아닙니다.
이 참가자는 출처를 밝힌 링크와 제목 정도는 가져와도 되고, 사진이나 기사 전체를 무단으로 수집·배포하는 것이 문제라고 덧붙였다. 다른 참가자는 대부분의 크롤링은 높은 확률로 무단이라고 했고, 네이버 뉴스 API를 쓰라는 대안이 제시됐다. 이 판단들은 모두 참가자 개인의 견해이며, 법적으로 확정된 해석으로 읽어서는 안 된다.
홈페이지 운영자의 시선
운영 쪽 경험은 더 구체적이었다. 한 참가자는 크롤링 때문에 홈페이지가 여러 번 중단된 일을 겪어 지금은 심하게 들어오면 서비스 보호를 위해 막고 있다고 했다.
근데 또 사이트나 인공지능 답변 때문에 다 막을 수도 없고 홈페이지 담당자 입장에서는 악의 축 ㅠㅠ
다른 참가자는 같은 IP의 요청을 차단하기보다 응답을 지연시키는 방식을 제안했다. 계획을 세운 참가자는 해당 홈페이지 관리자가 크게 문제 없다고 해서 일단 하고 있다고 답했는데, 크롤링 대상이 어디인지는 대화에 나오지 않았다.
해석
이 대화는 보안 우려에서 출발해 구성도로 넘어갔다가 다시 데이터 수집의 경계로 돌아왔다. 참가자들이 모델 선택보다 권한 경계, 벡터 DB, 수집 범위 같은 구조 문제를 먼저 말한 점은 공공 현장의 관심이 어느 모델을 쓰느냐에서 데이터를 어떻게 다루느냐로 옮겨 가고 있음을 시사한다. 다만 수집 허용 여부는 의견이 갈린 채로 끝났다.