OCR 전용 모델과 LLM 비전 파싱의 정확도 논쟁
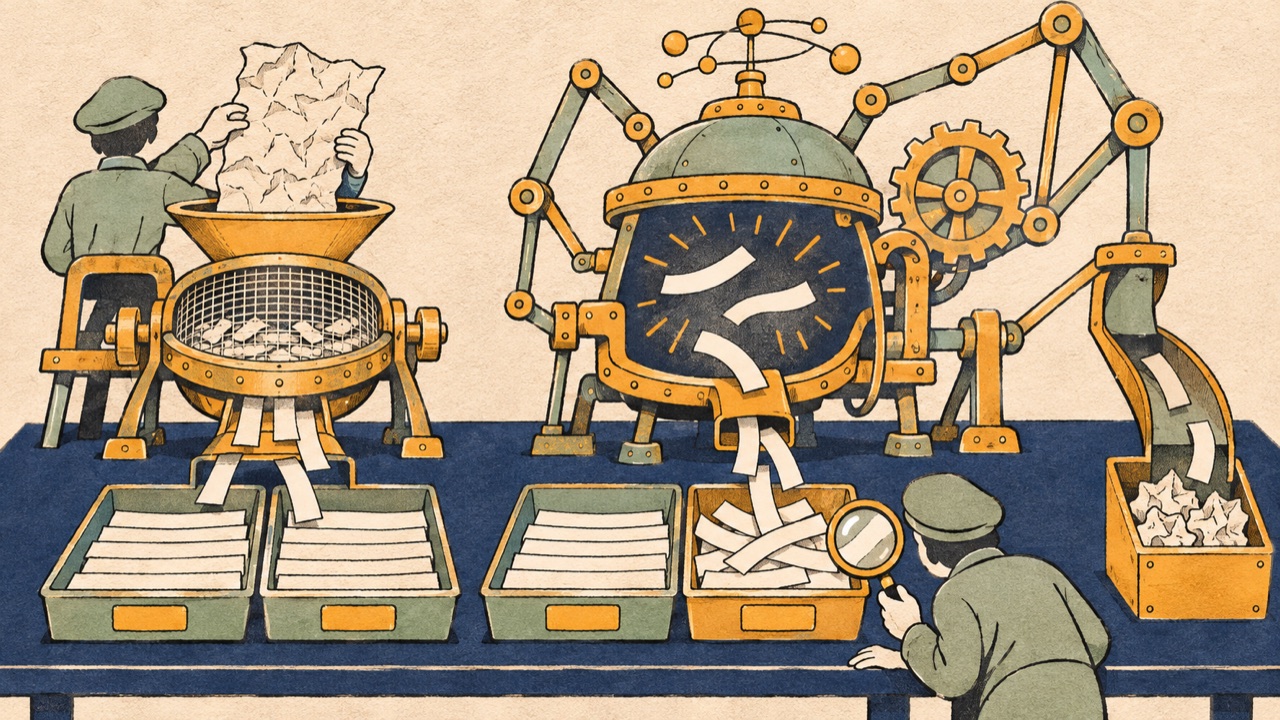
어제 밤 에이전트코리아에서 OCR 전용 모델과 LLM 비전 파싱 중 무엇이 정확한지, 그리고 둘을 어떻게 섞어 쓸지를 두고 오간 실무 대화를 정리한 기사.
어제 밤 11시 무렵 에이전트코리아에서 한 참가자가 짧게 물었다. 왜 OCR을 그렇게 파느냐는 것이다. OCR은 이미지 속 글자를 읽어 문자로 바꾸는 기술이다. 질문한 참가자는 이렇게 덧붙였다.
llm 비전파싱하면 되는데
LLM 비전 파싱은 대형 언어 모델에 이미지를 직접 보여 주고 내용을 읽게 하는 방식을 가리킨다. 이 한 줄에서 실무 경험담이 약 30분 이어졌다.
전용 모델이 낫다는 쪽
OCR 제품을 만든다는 참가자는 이유가 간단하다고 했다. 틀리기 때문이라는 것이다. 이 참가자는 정확도를 이렇게 비교했다.
LLM 큰놈으로 OCR 하는거보다 OCR모델이 정확도 높아요
약 15분 뒤에는 조건을 붙였다. 큰 LLM도 OCR을 잘하기는 하지만 최상위급이 아니면 정확도가 크지 않다는 말이다. opus는 모델 이름이고, 함께 적힌 sol은 대화에서 풀이되지 않았다.
다만 opus, sol 정도 아니면 정확도가 크지 않고
더 멋대로 지어내요 하위 모델로 가면
근거로 든 것은 환각이다. 환각은 모델이 없는 내용을 그럴듯하게 지어내는 현상이다. 이 참가자는 LLM은 환각을 어느 정도 허용하는 쪽이지만 OCR은 환각을 잡아야 하는 분야라고 했다.
OCR쪽은 환각을 잡아야 하니까
비용 이야기도 같은 참가자가 했다. 구조화된 데이터 파일 형식인 JSON으로 1000장을 최상위급 모델에 OCR시킨다고 가정하면 비용이 이렇게 나온다는 것이다.
1000장 json으로 오푸스로 OCR 시킨다고 하면
한 18만원 나옵니다
가벼운 모델에 대한 평가도 나왔다. 이 참가자는 가벼운 모델인 haiku로 OCR을 하면 답답하다고 했고, 성능이 쓸 만해지려면 이 정도는 되어야 한다며 이렇게 적었다.
gemini flash low 정도는 해야 성능 저정도 나옵니다
flash low는 가벼운 모델을 낮은 추론 설정으로 돌린다는 뜻으로 보이나, 대화에는 풀이가 없다. 비교에 쓴 문서나 측정 방법도 나오지 않는다.
무료 도구와 눈 검수
다른 참가자는 PaddleOCR을 쓴다고 했다. 이 참가자는 자기 경험도 같다며 인식이 좋다고 했고, 기울어진 글자도 잘 읽는다고 했다. 이유 하나는 가성비였다.
일단 무엇보다 onnx로 변환해서 쓸 수 있어서 가성비가 좋음
ONNX는 모델을 여러 환경에서 돌릴 수 있게 하는 형식이다. 같은 참가자는 그러면 서버로 보낼 필요가 없다고 했고, 고객이 올리는 이미지를 전부 유료 OCR에 맡기는 것은 자원 낭비라고 했다. 그러면서도 한계는 분명히 짚었다.
Ocr 솔직히 아무리 잘해도 눈으로 검토는 또 필요하긴하더라고요;;
이 참가자는 우편물의 주소만 읽어 와야 하는데 가끔 틀려서 검수하게 되면 그것도 피곤하다고 했다. 짧은 글은 검수하느니 직접 타이핑하는 편이 낫겠다는 말도 했다. 사람이 봐도 알아보기 어려운 사진이 올라오는 일도 있다고 했다. 판결문 인식 같은 일은 변호사들이 원하더라는 이야기도 같은 참가자가 전했다.
OCR 제품을 만든다는 참가자는 PaddleOCR이 신뢰도 값을 내주지 않아 아쉽다고 했다. 신뢰도 값이 있으면 의심스러운 결과만 따로 추려 검수할 수 있기 때문이다. 직접 돌려 본 뒤에는 이렇게 적었다.
Paddle은 숫자를 틀리는군요
같은 참가자는 보험 청구 같은 서류는 해외 API를 쓸 수 없다고도 했다. 이 말은 이 참가자 한 사람의 것이고, 판결문 이야기를 한 참가자의 발언에는 구동 위치에 대한 언급이 없다.
섞어 쓰는 구성과 개인 경험
또 다른 참가자는 두 방식을 합치는 구성을 내놓았다.
비전 파싱은 추론이 들어가요... 이게 독이 될때가 있죠.. 그래서 ocr쓰고 실패한것만 모아서 비전 파싱 가죠
OCR이 글자를 읽는 데 그친다면 비전 파싱은 내용을 헤아리는 추론이 끼어든다는 지적이다. 그 추론이 틀린 값을 만들 수 있으니 실패한 건만 넘긴다는 순서다.
또 다른 참가자는 작년에 물류 업무용으로 송장 인식을 만든 경험을 꺼냈다. 이 참가자의 순위는 이랬다.
제 경험에선 제미나이 API > 젬마 > 패들 > 이지 였는데
젬마는 구글의 공개 모델, 이지는 오픈소스 OCR 도구 EasyOCR로 보이지만, 이는 기사 설명이며 대화에서 풀이되지 않았다. 이 참가자는 작년 기준이라 지금은 어떨지 모른다고 덧붙였다. 인식 자체보다 현장 작업자가 쓰기 편하게 만드는 일이 더 큰 과제였다고도 했다.
읽어 둘 점
대화에서 같은 자료로 모델을 맞비교한 기록은 없고, 명시된 순위는 작년 경험 하나다. 전용 모델이 더 정확하다는 말은 OCR 제품을 만드는 참가자의 주장이다. 사람의 검수가 필요하다는 말은 PaddleOCR을 쓴다는 참가자가 거듭 했고, OCR 제품을 만드는 참가자는 의심스러운 결과만 골라 검수하게 하는 쪽을 말했다. 틀린 값을 어떻게 걸러 낼지가 선택의 핵심으로 거듭 언급됐다.