900만원 맥 스튜디오 대신 구독형과 NVIDIA GPU — 로컬 LLM 장비 질문에 개발자들이 실사용 수치로 답했다
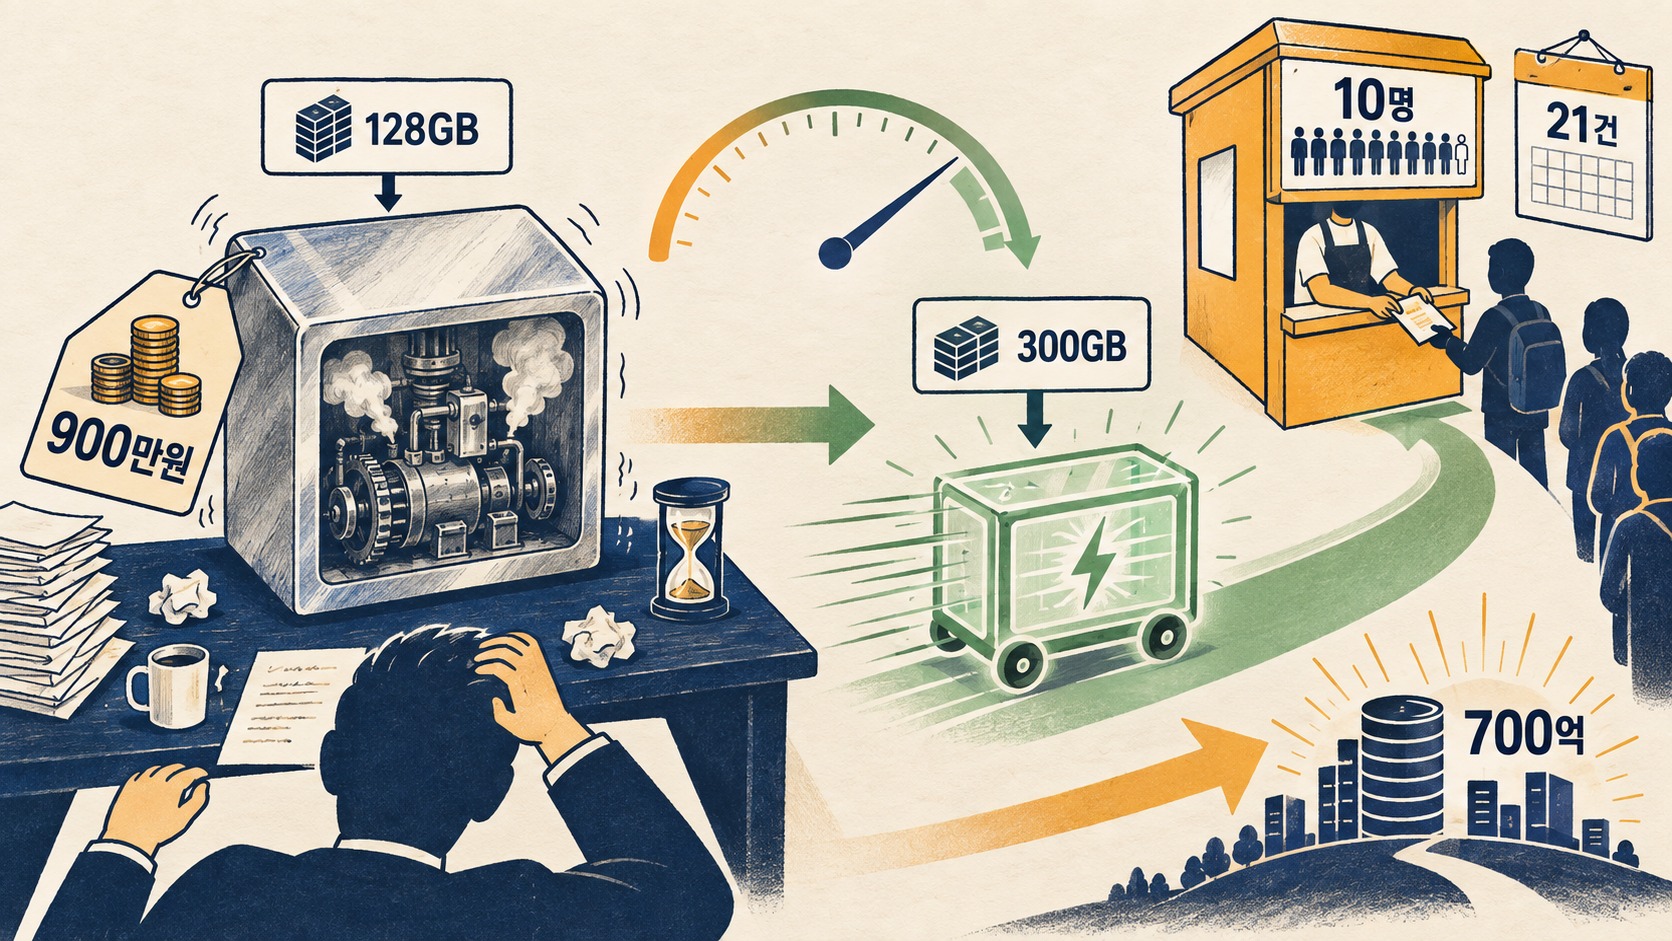
900만원대 맥 스튜디오로 로컬 LLM을 준비할지 묻는 질문에 쓰임새별 답이 오간 공공AX 대화
오후 세 시 무렵 공공AX 네트워크에 장비 질문 하나가 올라왔다. 한 참가자가 보안 이슈에 대비해 램 128GB 맥 스튜디오를 개인으로 사 둘지 물은 것이다.
이번에 나온 맥스튜디오 램128에 1테라 하드 정도 세팅하면 900만원정도 하는데
이 질문에는 10명이 21건을 주고받았다. 이날 방의 여섯 주제 가운데 참여자 수가 가장 많았다. 큰돈이 드는 장비 판단인 만큼 실제로 써 본 사람들의 답이 몰린 것으로 보인다.
개인이라면 구독형
첫 답은 기대치를 낮추는 쪽이었다. 한 개발자는 로컬 LLM(내 컴퓨터에서 직접 돌리는 대규모 언어 모델)의 성능이 기대보다 낮고, 개인이라면 구독형이 싸다고 답했다. 큰 장비값을 먼저 치르기보다 구독료를 내는 편이 낫다는 판단으로 읽힌다. 질문자가 개인 구매를 전제로 물은 만큼, 로컬 모델에 거는 기대와 실제 성능 사이의 간극부터 짚고 넘어간 셈이다.
올라가는 것과 빠른 것은 다르다
다른 개발자는 엔비디아의 소형 AI 장비인 DGX Spark(GB10 칩 기반) 실사용 경험을 전했다. 70b(파라미터 700억 개 규모) 모델도 올라가기는 하지만 디코딩(답을 한 토큰씩 만들어 내는 단계) 속도가 문제라는 것이다. 20b 모델은 혼자 쓸 때 초당 40토큰 수준이라고 했다. 모델을 메모리에 올리는 일과 쓸 만한 속도를 내는 일이 별개라는 점을 보여 주는 대목이다.
혼자 쓸 때라는 단서도 눈여겨볼 만하다. 같은 참가자는 병렬 성능은 나쁘지 않아 2 ~ 3명이 붙어도 초당 30토큰 안팎이 유지된다고 덧붙였다.
또 다른 참가자는 로컬 LLM이 메인이라면 NVIDIA를 먼저 고려하라고 권했다. 근거로는 CUDA(엔비디아 GPU용 연산 생태계)를 들었다. 다만 같은 참가자는 DGX Spark 같은 GB10 계열은 대역폭(메모리가 데이터를 주고받는 속도)이 300GB/s 미만이라 내부의 간단한 추론이나 시스템 테스트·파인튜닝 용도에 더 맞는다는 단서를 붙였다. 앞서 나온 디코딩 속도 문제와 같은 줄기의 지적으로 보인다. 맥으로 LLM을 하겠다는 선택에는 반대 의견이 나왔고 공감이 이어졌다.
맥으로 LLM 한다고 하면 전 말립니다..
쓰임새에 따라 갈린 답
답을 모아 보면 쓰임새에 따라 갈린다. 개인이 쓰는 정도라면 구독형, 로컬 LLM을 주력으로 돌린다면 NVIDIA GPU 쪽을 먼저 보되 GB10 계열은 가벼운 추론용이라는 조언이다. 질문이 보안 대비에서 출발했다는 점은, 적어도 한 참가자가 개인 차원에서 자체 장비를 고민하고 있음을 보여 준다.
늦은 오후에는 연휴 전보다 그래픽카드 가격이 확 뛰었다는 말도 나왔다. NVIDIA를 권하는 조언과 값이 오른 그래픽카드 사이에서 개인 구매 판단은 더 까다로워진 것으로 보인다. 이날 오간 속도 수치는 참가자 개인의 사용 경험에서 나온 값이라는 점도 함께 볼 대목이다. 결국 이날 답은 장비 하나를 고르기보다, 로컬 LLM을 얼마나 자주 무엇에 쓸지부터 정하라는 쪽으로 모였다.