8GB 노트북으로 1,800억 파라미터 로컬 LLM을 돌렸다
특별한 하드웨어 없이 노트북 한 대로 1,800억 파라미터 모델을 돌린 실험기.
16일 오전, 에이전트코리아 방에서는 로컬 LLM(Local LLM, 클라우드 서버 대신 자신의 컴퓨터에서 직접 구동하는 거대 언어모델) 하드웨어 이야기가 먼저 오갔다. 한 참여자가 대안 하드웨어와 모델 목록을 짧게 정리했다.
잉단 하드웨어는 텐토, 딥씩이, glm qwen
같은 참여자는 이어 실제 작업 방식도 소개했다.
Claude code에서 fable을 리뷰어로 두고 서브에이전트로 glm돌리면 쓸만해요
오후 3시 33분, 다른 참여자가 훨씬 구체적인 성과를 공유하며 분위기가 달라졌다. 8GB급 노트북 GPU로 1,800억 파라미터 모델을 양자화(Quantization, 모델 가중치를 더 적은 비트 수로 압축해 용량과 연산량을 줄이는 기법)해 로컬로 구동했다는 소식이었다.
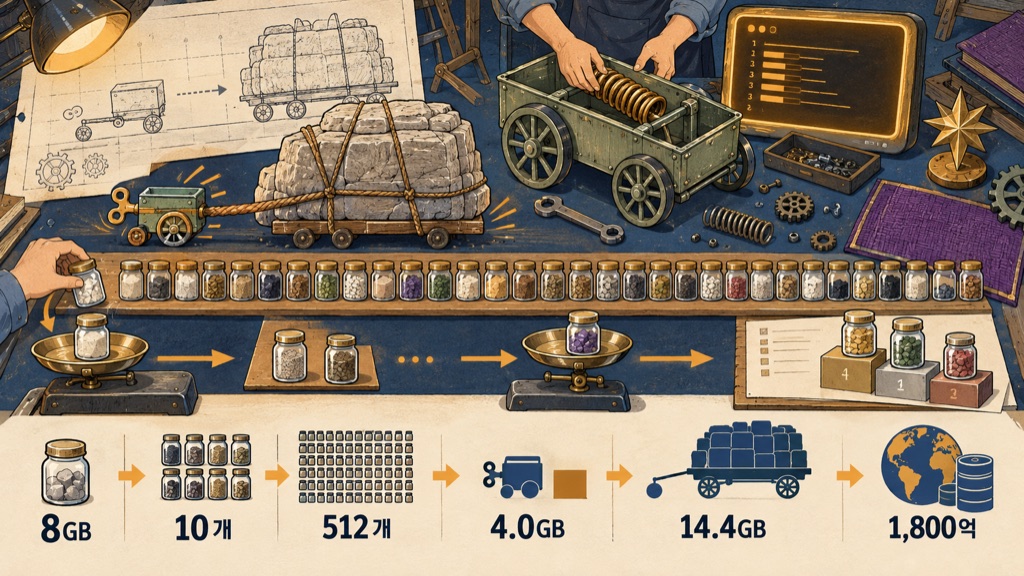
이번엔 8GB 노트북 GPU로 1,800억 파라미터입니다. Qwen3.8-Flash-Next(176.94B, MoE 512 전문가 중 10개 활성)를 제 노트북에서 로컬로 돌렸습니다.
MoE(Mixture of Experts, 512개의 하위 전문가 모델 중 일부만 골라 활성화해 연산량을 줄이는 구조)를 활용한 176.94B 규모 모델을 4비트로 직접 양자화했고, VRAM 4.0GB·RAM 14.4GB 선에서 실행됐다고 밝혔다. 생성 속도는 다음과 같이 실측됐다.
생성 속도 4.17 ± 0.17 tok/s (256토큰, 반복 2회)
같은 참여자는 여기서 멈추지 않고, 램 64GB급 미니PC로 두 자릿수 tok/s를 목표로 이식 작업을 진행 중이라고 덧붙였다. 오후 4시 1분에는 별도로 준비 중인 벤치마크 소식도 전했다.
그래서 '오픈라우터 리더보드'를 만들어봤어요. 오늘 허깅에 공개할려구요. 오픈라우터 API로 전 모델을 실제 요청해서 실측값을 다 뽑았음
오픈라우터(OpenRouter, 여러 회사의 LLM API를 한 곳에서 호출할 수 있게 중개하는 서비스) 425개 전 모델을 실제 API 호출로 실측했다는 이 리더보드는, 스펙 표가 아니라 실사용 데이터를 기준으로 모델을 비교하려는 시도로 읽힌다.
같은 날 오전의 하드웨어 잡담과 오후의 실측 성과가 한 사람의 발화로 이어졌다는 점은, 이 커뮤니티에서 로컬 LLM 구동이 더 이상 이론적 관심사가 아니라 개인 노트북 한 대로도 시도해볼 수 있는 실전 영역으로 넘어왔음을 시사한다. 특별한 하드웨어 없이도 대형 모델을 돌릴 수 있다는 사실 자체가, 로컬 구동의 진입장벽을 낮추는 신호로 읽힌다.
이 화두에는 23명이 참여해 147건의 메시지를 남겼다.