로컬 GPU 논의는 5090 두 장에서 2억 원대 미니PC까지 뻗었지만, 한 참여자는 5070ti로도 충분하다는 체감을 밝혔다
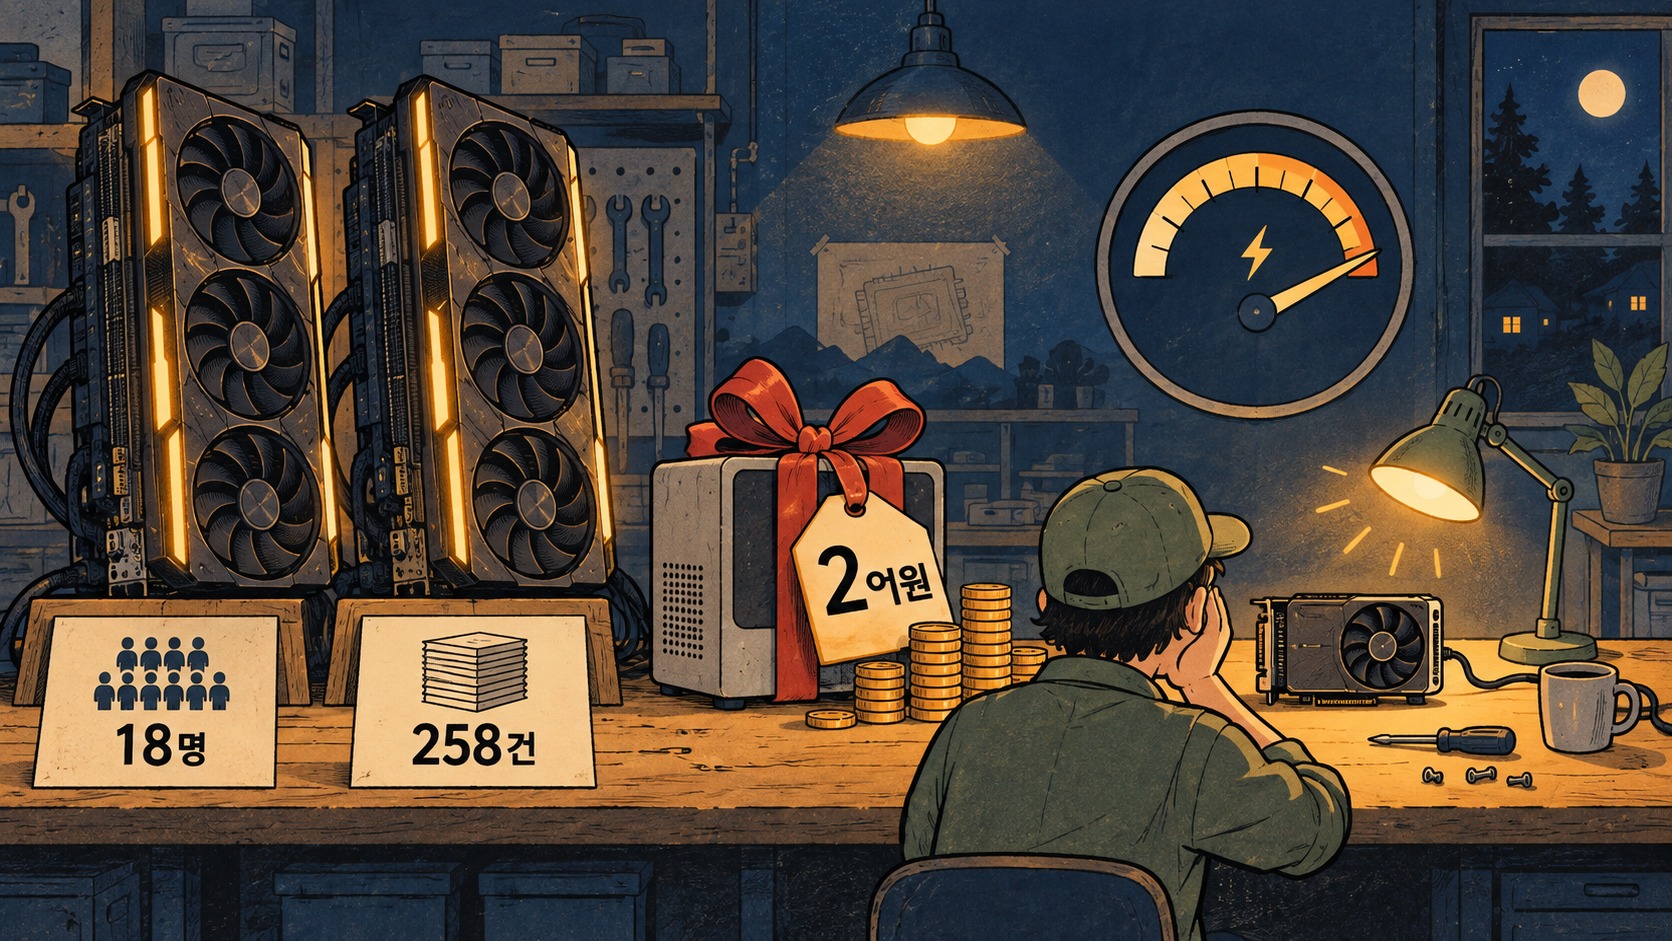
5090 두 장 활용 고민에서 GGUF·llama.cpp 정리, 5070ti면 충분하다는 체감까지 이어진 에이전트코리아 로컬 GPU 대화
오전 9시 20분을 넘겨 에이전트코리아에 장비 이야기가 올라왔다. 한 참여자가 5090 두 대를 연결해 둔 상태에서 어떻게 써 볼지 고민 중이라고 털어놓았고, 답글들이 장비 가격 쪽으로 이어졌다. 이 주제에는 18명이 258건을 주고받았다.
장비 가격 이야기는 곧바로 위쪽으로 뻗었다. 한 참여자는 GB300이 달린 미니PC가 2억 원 정도 한다고 짚으면서, 이제는 머신이라고 불러야 한다고 덧붙였다. 개인이 사서 쓰는 GPU 이야기가 한순간에 서버급 가격표로 올라간 셈이고, 이 대비가 뒤이어 나온 신중한 평가를 더 도드라지게 만든다. 다만 이 금액은 참여자의 전언이며 방에서 따로 확인된 값은 아니다.
용어부터 정리한다
오후에는 질문이 장비에서 소프트웨어로 옮겨 갔다. 한 참여자가 GGML, GGUF, llama.cpp의 역할을 정리해 올리며 런타임별 정확도 차이와 CPU·GPU를 함께 쓰는 방법을 물었다. 정리의 요지는 세 가지가 서로 다른 층에 있다는 것이었다.
GGUF: 모델 가중치와 설정을 저장하는 파일 형식
계산을 맡는 라이브러리가 GGML이고, 그 라이브러리로 GGUF 모델을 돌리는 엔진이 llama.cpp라는 설명이 함께 나왔다. 파일 형식과 실행 엔진을 헷갈리지 않아야 런타임을 비교할 수 있다는 문제의식으로 읽힌다. 질문이 정확도 차이와 CPU·GPU 병행으로 향했다는 점에서, 장비를 갖춘 다음 단계의 고민이 이미 시작된 모습이기도 하다.
얼마나 들일 가치가 있나
이어서 최적화를 두고는 냉정한 평가가 나왔다. 한 참여자는 들이는 노력에 비해 품질 향상이 적다고 했다. 장비 이야기와 정반대 방향의 말이 한 대화 안에 나란히 놓인 것이다. 런타임별 차이를 물은 질문에 대한 답으로 보면, 런타임 차이를 묻던 참여자가 직접 겪은 소감으로, 노력 대비 효과가 적어 최적화를 미루겠다는 취지였다.
근데 제가 느껴본바로는 로컬 llm으로 연구하는 목적아니면 5070ti로도 충분한거 같아요..
이 말은 어디까지나 한 참여자의 체감이며, 어떤 모델을 어떤 용도로 돌렸는지는 방에 옮겨지지 않았다. 그럼에도 대화 전체를 놓고 보면 흐름이 분명하다. 오전에는 장비가 점점 비싼 쪽으로 이야기됐고, 오후에는 용어 정리와 효율 평가가 이어졌으며, 오후 2시 반 무렵에는 한 참여자가 연구 목적이 아니라면 5070ti로도 충분하다는 체감을 밝혔다.
결국 이날 대화는 로컬 모델 선택의 기준이 GPU 숫자에서 쓰임새로 옮겨 가고 있음을 시사한다. 장비를 먼저 고르고 용도를 나중에 묻는 순서가 뒤집히고 있다는 해석도 가능하지만, 근거는 이 대화 한 토막이다. 다만 전일 digest에는 같은 주제가 없어, 이것이 이어지는 추세인지는 이 입력만으로 판단하기 어렵다.