판정 전용 모델 JEV(제브), 사흘 만에 세 커뮤니티를 동시에 흔들다
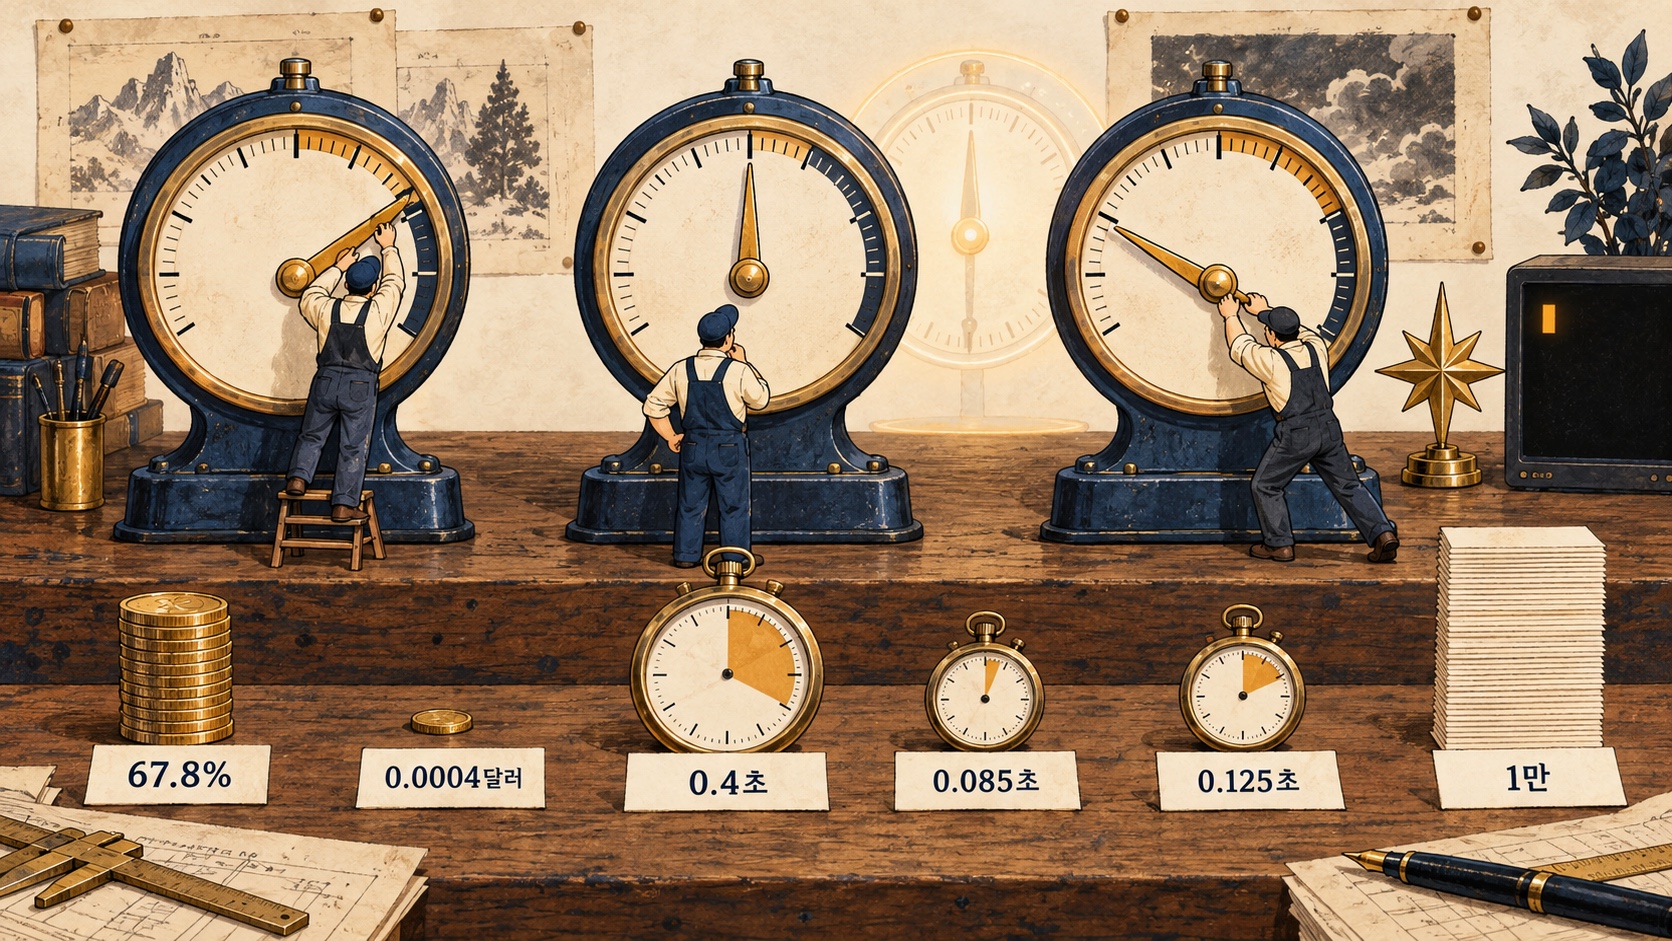
판정 전용 모델 JEV(제브)가 세 커뮤니티에서 동시에 화제가 됐다 — 벤치마크·오픈소스 재현부터 실전 적용 회의론까지, 방마다 다른 실험이 엇갈렸다.
9/18 오후, 오픈AI 출신 인력이 만들었다는 판정 전용 모델 'JEV(제브)'가 에이전트코리아에 처음 등장했다. 그날 저녁 에르메스단이 뒤를 이었고, 이튿날 낮에는 더배러까지 가세했으며, 처음 불붙은 에이전트코리아에서는 사흘째인 20일 오전까지도 제브 이야기가 이어졌다. 그렇게 사흘 내내 세 방의 대화를 붙들어맸다. 세 방 모두 "이게 뭐 하는 물건이냐"는 질문으로 시작해 벤치마크와 오픈소스 재현으로 번져갔지만, 도달한 결론은 조금씩 달랐다.
추론이 아니라 확률 판정
JEV는 긴 글을 순차 생성하는 여느 LLM과 다르다. 커뮤니티에 공유된 자료에 따르면 이 모델은 토큰 대신 확률을 병렬로 출력하는 'System One' 구조를 표방하며, 네 가지 워크플로 테스트에서 평균 정확도 67.8%·건당 0.0004달러·0.4초의 비용과 속도를 기록했다고 알려졌다. 텍스트를 만드는 대신 타입이 정해진 결정만 내놓아 환각을 줄이는 설계라, 분류·라우팅·심사처럼 "예/아니오·점수"로 끝나는 판정 작업에 맞춰져 있다는 설명이었다. 더배러의 한 참여자는 이 구조를 구체적인 예시로 풀어 설명했다.
예를 들어서 “이 고객이 환불을 요청했나?”라고 물으면: - 0.98 → 거의 확실히 요청했다고 판단 - 0.50 → 요청했는지 애매하다고 판단 - 0.02 → 거의 요청하지 않았다고 판단
세 방, 같은 모델 다른 실험
에이전트코리아에서는 곧바로 벤치마크 대결이 벌어졌다. 참여자들은 GLM 모델을 개조한 버전과 오픈소스 재현판 '오픈제브'의 속도·정확도를 JEV 원본과 나란히 세웠다.
테스트중인데 glm 마개조 해보니깐 jev 0.085초 마개조 0.125초
같은 참여자는 정확도 쪽에서도 "오픈제브가 0.7 jev가 0.94 제가올린게 0.96"이라고 전해, 자체 개조판이 오히려 원본보다 앞섰다는 결과를 공유했다. 원본이 빠르긴 해도 절대적이지는 않다는 정황이 이 방의 수치 대결에서 드러난 셈이다.
에르메스단은 실전 활용 쪽에 무게를 실었다. 웨이팅리스트 신청과 오픈소스 대체재(openjev·jevlike·ultrajev) 논의가 오갔고, 브라우저·컴퓨터 유즈 자동화와 묶어보려는 시도도 있었다 — 코덱스의 브라우저 유즈를 JEV로 대체할 수 있는지를 묻는 참여자, 어사이드(브라우저 자동화 도구) 연동 가능성을 궁금해하는 참여자가 이어졌다. 실제 업무에 적용해본 후기도 남았다.
Jev 쩌네요 메일정리 1만통 메일분류 5분만에 하네요
같은 방에서는 한계도 함께 보고됐다. 다른 참여자는 "jev 근데 한국어 인식율이 떨어지더라구요"라며, 한국어로 비꼬는 말은 잘 못 알아듣는데 영어로 된 비슷한 표현은 잘 알아듣는다고 전했다.
더배러는 지능 향상 효과엔 가장 신중했지만, 저비용 판정 활용례는 오히려 활발했다. 한 참여자는 같은 기획서를 JEV 도입 전후로 나눠 클로드 페이블(Fable)과 아스트라(Astra) 두 모델로 비교 분석했고, "jev도입했을 때 더 똑똑하게 작업한다. 는 없는 것 같습니다"라는 결론을 전했다. 이 방에는 외부 활용 사례도 여럿 공유됐다 — 웹사이트 586페이지를 45초 만에 분석해 내부 링크를 재구성한 사례(비용 0.21달러, 비교 대상 대비 페이지당 약 190배 저렴), 광고 724개를 40초·9센트로 분석한 사례 등 저비용·고속 판정 작업 쪽 활용례가 몰렸다.
쓸 자리와 한계
에르메스단의 한 참여자는 JEV가 맞는 자리를 이렇게 짚었다.
현존하는 거대모델은 확실히 답변에 맞춰져있어서 빠른 판단만 요구하는 task에서 퍼포먼스가 아쉬웠는데 (과하게 시간이나 토큰을 쓰는) jev는 딱 tool call에 필요한 만큼을 취해서 >> 분기가 명확한 로직 내에서 활용도가 높아진다
정리하면 분류·라우팅·게이트·대량 태깅처럼 갈림길이 뚜렷한 판정에는 강하지만, 글쓰기·산술·복잡한 추론은 애초에 설계 대상이 아니라는 게 세 방 공통의 결론에 가깝다. 가격·정확도 수치도 만든 쪽 자료와 데모에 기반한 것이어서 실제 트래픽에서 별도 검증이 필요하다는 신중론도 함께 따라붙었다.
세 방이 동시에 이 모델에 반응한 배경에는 공통된 실무 압박이 있어 보인다. 세 방 모두 최근 사용량 한도·구독료 부담을 하소연해온 시기였던 만큼, 토큰을 많이 먹는 대형 모델 대신 값싸고 빠르게 "예/아니오"만 판정해줄 보조 모델에 대한 수요가 동시에 터져 나온 것으로 보인다. 제조사가 공개한 벤치마크를 그대로 받아들이기보다 각자 개조·재현해 직접 검증하려는 태도가 세 방에서 동시다발적으로 나온 점도 눈에 띈다.